Label shift occurs when target-value distributions differ between training data and unseen application data. In solubility modeling, training only on highly soluble molecules can leave a model unprepared for molecules spanning the full solubility range. section 4.1.2
Inspect target distributions before modeling. Similar solubility distributions in training and validation data suggest no visible shift there, while a broader application range may require models that extrapolate better. section 4.1.2
Figure 4.1 Comparison of solubility distributions for train and validation data sets.
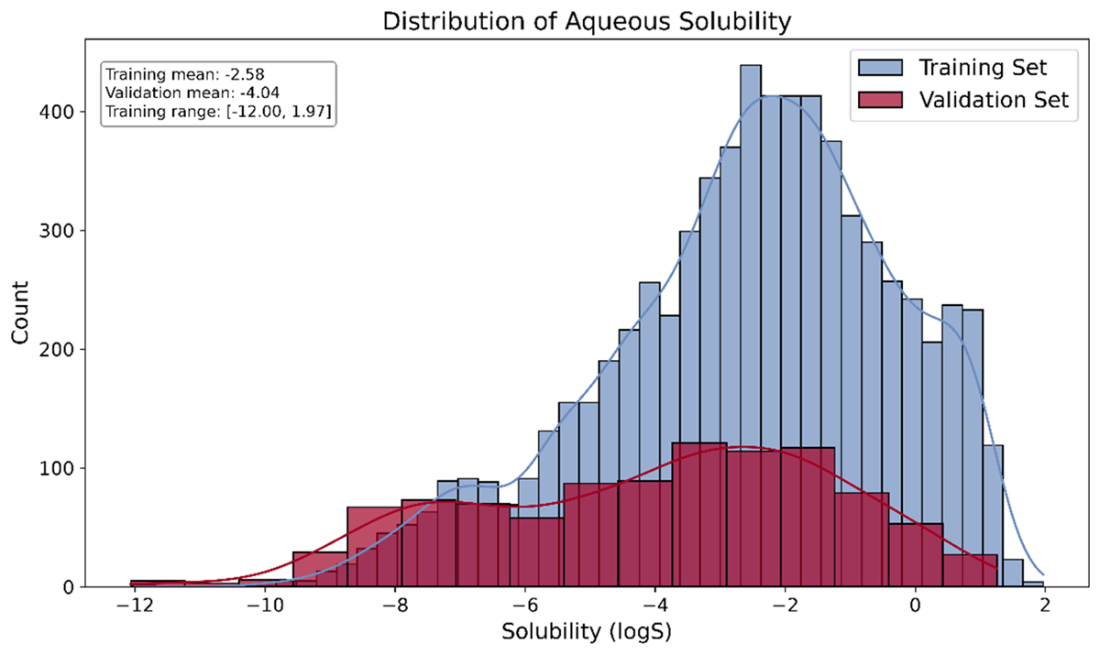
Compare solubility distributions across training and validation data to identify potential target-distribution discrepancies. section 4.1.2
