liveBook · Manning

NaturalVariationalDistribution

As explained in Bayesian Optimization in Action

NaturalVariationalDistribution is a GPyTorch variational-distribution implementation whose parameters are represented for natural-gradient optimization.

NaturalVariationalDistribution is the variational-distribution component that enables natural-gradient optimization in a GPyTorch variational Gaussian process. It replaces an ordinary variational distribution while the model retains an ApproximateGP, variational strategy, mean function, covariance function, and forward method. section 12.3

Figure 12.15 An illustration of gradient descent, mini-batch gradient descent, and natural gradient descent within a loss “valley,” where the center of the valley gives the lowest loss. By accounting for the geometry of the loss function, natural gradient descent reaches the loss minimum more quickly than mini-batch.
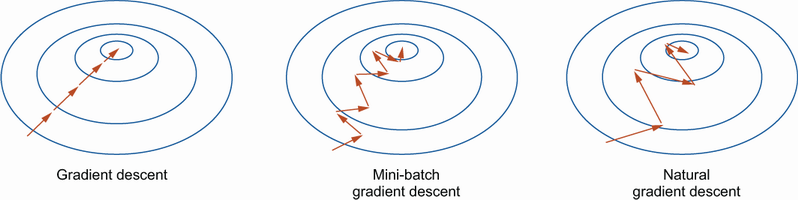
Natural gradient descent accounts for the loss geometry and can reach the minimum faster than mini-batch gradient descent. section 12.3

Minimal configuration

Create a VGP with 50 inducing points, attach a Gaussian likelihood, and train it with NGD plus Adam; the resulting predictions are reported as excellent.

How Bayesian Optimization in Action covers it

How deep it goes
Explains construction, optimizer separation, mini-batch updates, and train/evaluation mode changes, but does not detail parameterization internals.
Examples
Uses a one-dimensional objective, 50 inducing points, mini-batches, paired NGD and Adam optimizers, and trained VGP predictions.
What it assumes
Assumes familiarity with ApproximateGP models, variational strategies, inducing points, likelihoods, and mini-batch optimization.
What you can do after
Operate/configure GPyTorch VGP training with NGD for variational parameters and Adam for remaining parameters.
How it connects
Connects variational distributions with variational strategies, natural gradient descent, variational parameters, Adam, and variational ELBO.

Related concepts

This explainer was generated by Manning's knowledge graph from the text of Bayesian Optimization in Action. The section links point to the parts of the book it draws on.