liveBook · Manning

Regularization

As explained in Machine Learning System Design

Regularization is a technique that constrains model fitting to discourage overly complex solutions and improve generalization.

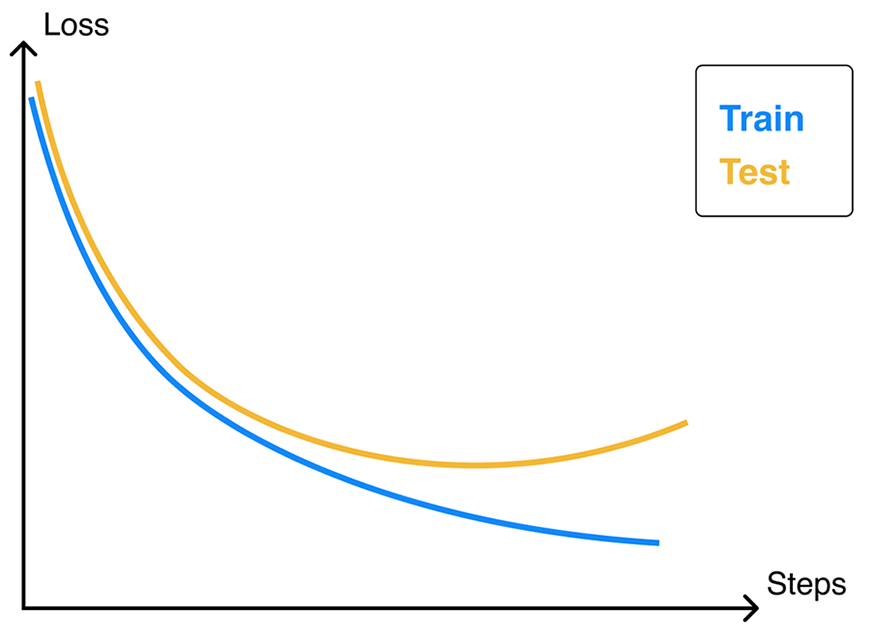
Regularization constrains model fitting to discourage overly complex solutions and improve generalization. It becomes relevant when training loss falls while validation loss rises, signaling overfitting caused by high variance. section 9.1.3

Use the loss curves to guide the response:

  • Confirm that the pattern is genuine rather than caused by an implementation problem, such as incorrect normalization. section 9.1.3
  • Restrict model capacity by reducing model complexity directly or increasing regularization. section 9.1.3
Figure 9.6 Loss is decreasing for training but not validation, reflecting potential overfit.
figure

Compare training and validation loss curves to recognize the visual signature of potential overfitting. section 9.1.3


How Machine Learning System Design covers it

How deep it goes
Explains the overfitting pattern and recommends capacity reduction or stronger regularization, without detailing specific methods.
Examples
Uses diverging training and validation loss curves, plus normalization errors as a diagnostic contrast.
What it assumes
Assumes familiarity with training loss, validation loss, model complexity, and basic loss-curve interpretation.
What you can do after
Diagnose overfitting from loss curves and choose between reducing complexity and increasing regularization.
How it connects
Connects regularization with overfitting, high variance, model capacity, training loss, and validation loss.

Also explained in

Compare how 13 books explain regularization →

Related concepts

This explainer was generated by Manning's knowledge graph from the text of Machine Learning System Design. The section links point to the parts of the book it draws on.










