Variance is error caused by a model’s sensitivity to small fluctuations in its training data. High-variance models fit insignificant patterns, behave differently on new data, and often overfit. section 9.1.1
Use variance to reason about model complexity and evaluation stability:
- Balance it against bias: increasing model capacity can reduce bias while increasing variance; reducing variance often increases bias. section 9.1.1
- Treat validation variance as estimate noise: more cross-validation folds can reduce bias but increase variance because each validation fold contains fewer samples. section 7.2.3
- Choose validation schemas using bias, variance, computation time, and the differences between seen and unseen data. section 7.6
- Measure consistency when small changes to input data, training data, or training procedures should not substantially change predictions. section 5.2.1
Search ranking stability
For a search engine, measure the variance of a document’s rank for a query across releases and document/query corpora. Lower variance indicates more stable behavior, but a constant model can achieve low variance without useful consistency. section 5.2.1
Figure 5.5 New model releases are fairly consistent when estimating the probability (P) of the user (U) being fraudulent (F).
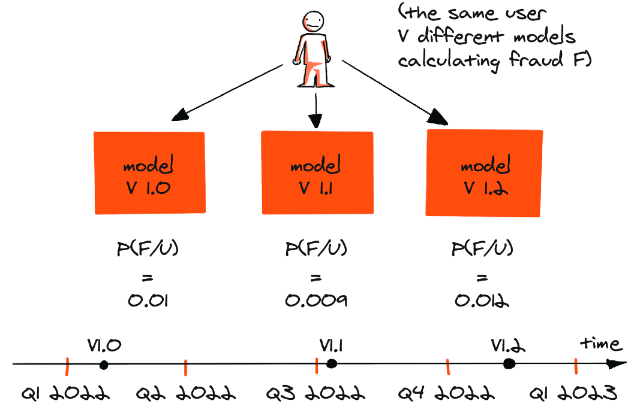
Compare model releases by examining how consistently they estimate fraud probability for the same user. section 5.2.1


















