A data distribution assigns probabilities to possible outcomes. In language models, it ranks candidate next words after a given sequence, making likely and unlikely continuations distinguishable. section 2.1
Phone keyboard suggestions
After entering “I am,” a keyboard model may rank “away” highly and “sandalwood” very low. Choosing “away” updates the distribution for the next prediction. section 2.1
Figure 2.1 Probability distribution in action
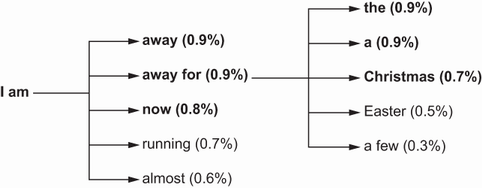
Visualizes how candidate words receive different probabilities after a partial phrase. section 2.1


























